
监控和告警
从 CPU、内存、存储和网络等方面对虚拟机进行监控和告警。为便于及时告警,还可以配置通知策略。
直观呈现的监控数据可为运维巡检或性能调优提供决策支持,而完善的告警和通知机制则有助于保障虚拟机的稳定运行。
监控
默认情况下,平台会收集虚拟机常用的性能监控指标,包括 CPU、内存、存储和网络。进入 虚拟化 > 虚拟机,在虚拟机详情的 监控 选项卡中,可以查看这些指标的实时监控数据。
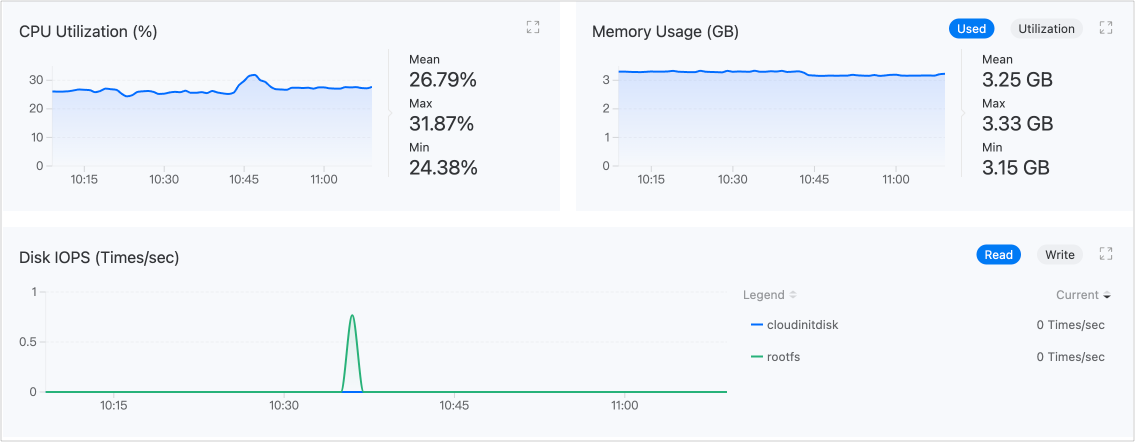
告警
配置告警策略
要启用告警,必须先创建告警策略。告警策略用于描述你希望监控的对象、希望在什么条件下接收告警,以及如何接收相关告警通知。进入 容器平台 > 虚拟化 > 虚拟机,在虚拟机详情的 告警 选项卡中,点击 创建告警策略 完成配置。
提示:虚拟机告警功能与平台的通用告警功能类似。有关更详细的配置指导,请参阅平台的通用告警文档。
处理告警
进入 告警 选项卡,如果存在告警状态策略提示,请及时处理。
绑定通知策略
除了在 告警 选项卡中进行实时告警外,平台还支持通过 email、SMS 等方式将告警信息发送给相关人员,通知他们采取必要措施解决问题或防止故障。通知策略需要联系管理员进行设置。
使用 API
告警策略基于 Prometheus 规则。你也可以直接将告警定义为 PrometheusRule(monitoring.coreos.com/v1):
KubeVirt 会输出按每个 virtual machine instance 划分的指标(前缀为 kubevirt_vmi_*,并带有 namespace 和 name 标签),你可以在 Prometheus 中查询,或用于你自己的 dashboard——例如 kubevirt_vmi_memory_used_bytes、kubevirt_vmi_network_receive_bytes_total、kubevirt_vmi_storage_read_traffic_bytes_total 和 kubevirt_vmi_migration_data_processed_bytes。准确的指标名称会因 KubeVirt 版本而异;可通过查询 {__name__=~"kubevirt_vmi_.+"} 列出完整集合。