
服务性能监控(SPM)
Service Performance Monitoring 在 Jaeger UI 中以“Monitor”选项卡的形式呈现,可在无需预先了解服务或操作名称的情况下帮助识别有价值的 traces。该功能会聚合 span 数据以生成 RED(Request、Error、Duration)指标。
UI 功能概览
Monitor 选项卡提供服务级和操作级的聚合视图,包含:
- 请求速率
- 错误速率
- 持续时间(P95、P75、P50)
“Impact” 指标通过延迟与请求速率的乘积计算得出,有助于识别尽管延迟表现不同但业务影响较高的操作。
架构
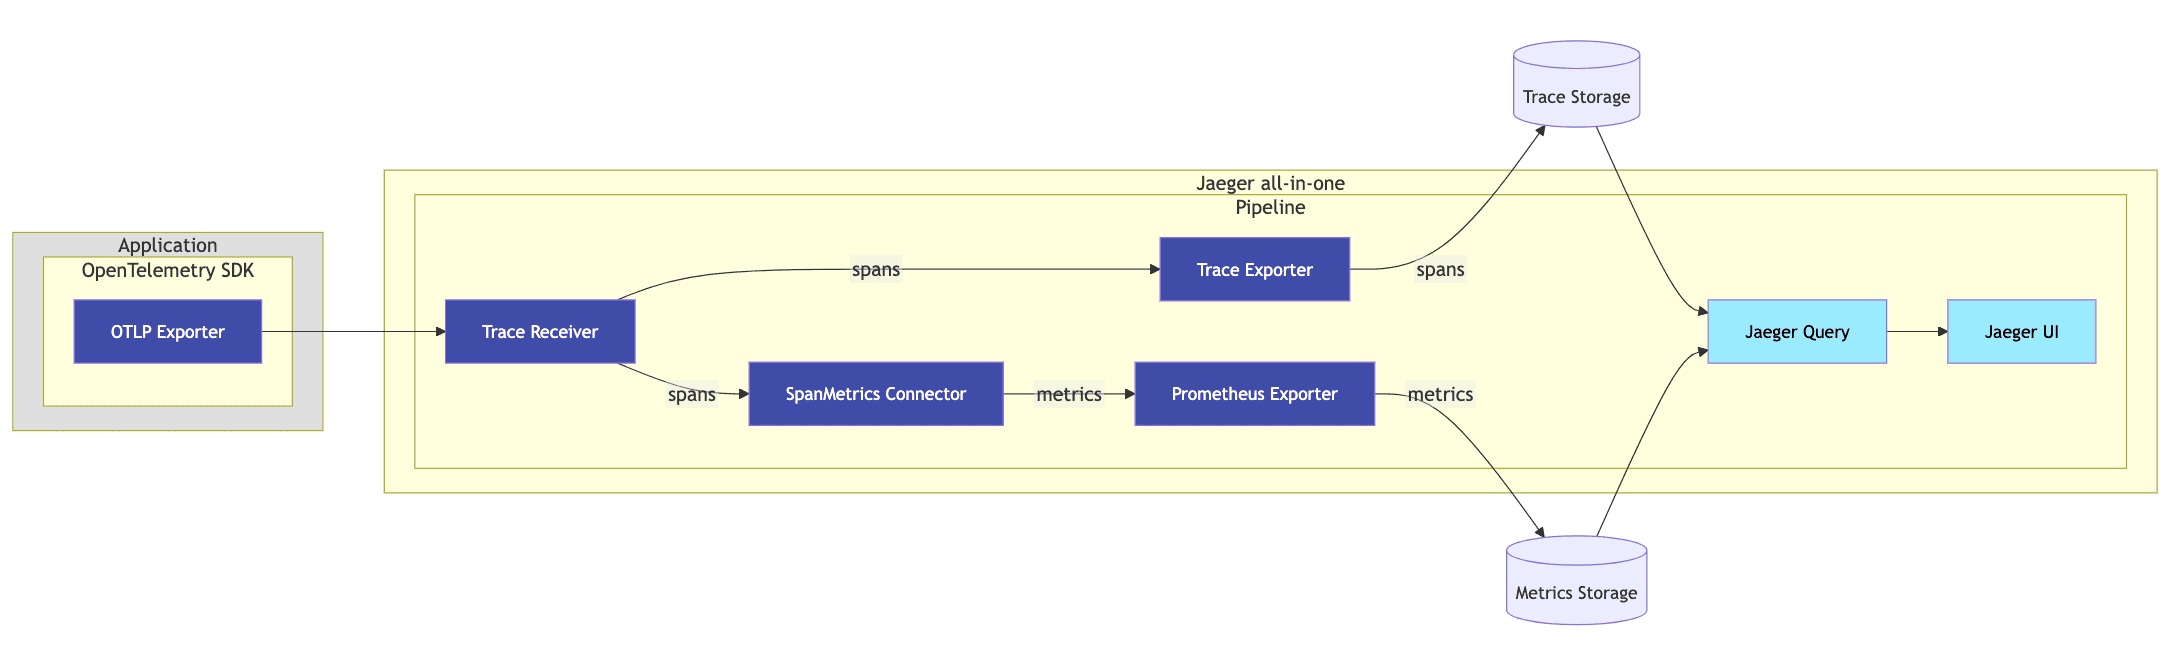
SpanMetrics Connector 接收 span 并生成导出到支持 PromQL 的后端的指标。随后 Jaeger Query 检索这些预计算指标。此方法需要:
- 在接收 trace 数据(span)并生成 RED 指标的流水线中引入 SpanMetrics Connector。
- 一个支持 PromQL 查询的外部 Metrics Store。
- 在
jaeger_query扩展中进行配置,以引用外部 metrics store。
由于该 connector 会将 span 聚合为内存中的 series,因此每个 (service, operation) time series 必须由单写入者生成。使用一个 collector replica 时,这一点会自动满足。要进行横向扩展,必须按 service 对 span 进行负载均衡,使每个 service 恰好由一个 instance 聚合;否则 RED 指标会被重复统计并变得不准确。有关生成的两层设置,请参见配置。
派生时间序列
SpanMetrics Connector 生成两个 metric 名称:
traces_span_metrics_calls(counter 类型)
- 统计所有 span,包括错误 span
- 通过
status_codelabel 区分调用数与错误数 - 将
status_code = "STATUS_CODE_ERROR"的 time series 识别为错误
traces_span_metrics_duration(histogram 类型)
- span 持续时间/延迟的 histogram
- 生成额外的 time series:
traces_span_metrics_duration_count:所有 bucket 中数据点的总数traces_span_metrics_duration_sum:所有数据点值的总和traces_span_metrics_duration_bucket:每个 bucket 对应的 time series 集合
估算 time series 数量的计算方式:
配置
SPM 采用两层架构运行,这样有状态的 SpanMetrics Connector 始终能以单写入者的方式看到每个 service,即使两层都运行多个 replica,也能保持 RED 指标准确。
前端 OpenTelemetry Collector — 按 service 将 span 负载均衡到后端:
Jaeger — 运行 SpanMetrics Connector,并在 Prometheus 端点上暴露生成的指标:
exporter 和 Jaeger metrics reader 必须就 metric 名称达成一致。默认情况下,Jaeger 会查询不带后缀的名称,例如 traces_span_metrics_calls(prometheus metric backend 的 normalize_calls 和 normalize_duration 选项默认值为 false),因此 exporter 不得附加 Prometheus 风格的后缀。为此请显式设置 translation_strategy: UnderscoreEscapingWithoutSuffixes:较旧的 add_metric_suffixes: false 选项自 Jaeger v2.20.0(collector-contrib v0.154.0)起已被弃用并会被静默忽略,这会将 metrics 重命名为 traces_span_metrics_calls_total,从而破坏 Monitor 选项卡。
在 Jaeger 中定义一个兼容 PromQL 的远程存储:
在 jaeger_query 扩展中引用该 metrics store:
一旦 jaeger_query 引用了 metrics store,Jaeger UI 中就会自动显示 Monitor 选项卡。其可见性来源于后端报告的 storage capabilities,因此无需额外的 Jaeger UI 配置文件。