
架构
Alauda Distributed Tracing 基于 Jaeger v2 和 Alauda Build of OpenTelemetry v2。Jaeger 实例通过 OpenTelemetry Operator 部署,后端存储使用 Elasticsearch 或 OpenSearch。在此架构中,Jaeger v2 为数据摄取、查询和可视化提供核心 tracing 后端能力。
Jaeger v2 的设计目标是成为一个多用途且灵活的 tracing 平台。它可以作为单个二进制文件部署,并通过配置在 Jaeger 架构中承担不同的 roles。
目录
Roles存储架构直接写入存储使用 OpenTelemetry Collector作为 sidecar / host agent 的 OpenTelemetry Collector作为远程集群的 OpenTelemetry CollectorJaeger BinaryJaeger ComponentsOpenTelemetry ComponentsReceiversProcessorsExportersConnectorsExtensionsRoles
- collector: 接收来自应用程序的传入 trace 数据,并将其写入存储后端。
- query: 提供用于查询和可视化 trace 的 API 和用户界面。
- es-rollover: 管理 Jaeger 在 Elasticsearch 和 OpenSearch 上基于 rollover 的索引操作。它用于为 rollover 部署准备别名、索引和模板,并可定期将写入别名切换到新索引,同时更新读取别名。
- es-index-cleaner: 删除早于配置保留期限的基于时间的索引。它匹配带日期后缀的索引(
<prefix>-jaeger-(span|service|dependencies|sampling)-YYYY-MM-DD),并移除已超过保留阈值的索引。它适用于将 trace 存储在带日期后缀索引中的部署;对于在 Elasticsearch 上使用带 Index Lifecycle Management (ILM) 的 rollover 别名,或在 OpenSearch 上使用 Index State Management (ISM) 的安装,则由生命周期策略接管保留管理。
存储架构
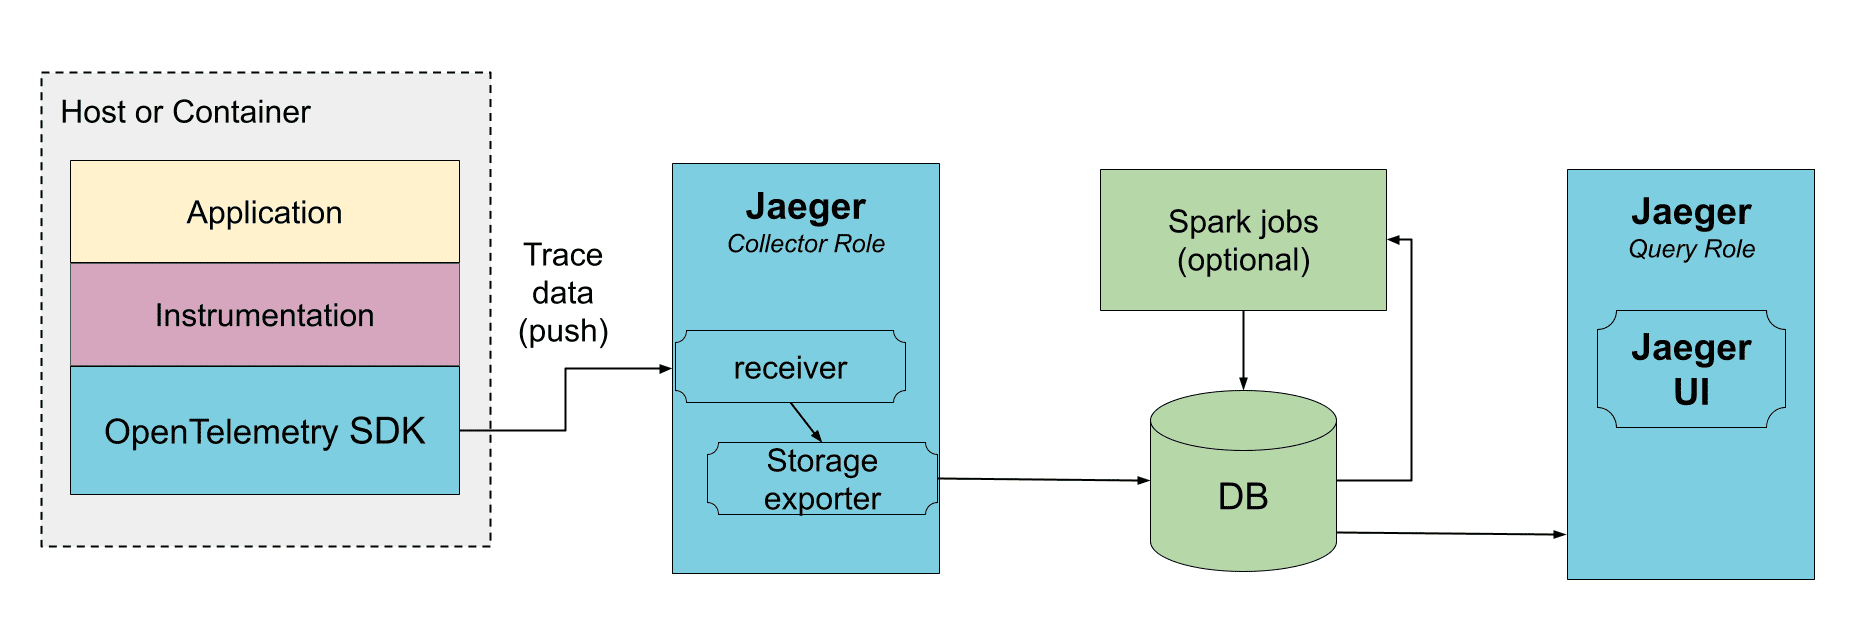
直接写入存储
在此部署方式中,collector 会接收来自被追踪应用的数据,并直接写入存储。存储必须能够同时处理平均流量和峰值流量。collector 可能会使用内存队列来平滑短期流量峰值,但如果存储无法跟上,持续的流量激增可能会导致数据丢失。
使用 OpenTelemetry Collector
你不需要使用 OpenTelemetry Collector 来运行 Jaeger,因为 Jaeger 是基于 OpenTelemetry Collector 并针对不同 roles 进行定制的发行版。不过,如果你已经在使用 OpenTelemetry Collector 来收集其他类型的 telemetry,或对 tracing 数据进行预处理/增强,它可以放在 Jaeger 前面,作为收集流水线的一部分。OpenTelemetry Collector 可以作为 application sidecar 运行,也可以作为远程服务集群运行。
OpenTelemetry Collector 支持 Jaeger 的 Remote Sampling 协议,既可以直接从配置文件提供静态配置,也可以将请求代理到 Jaeger 后端(例如,使用自适应采样时)。
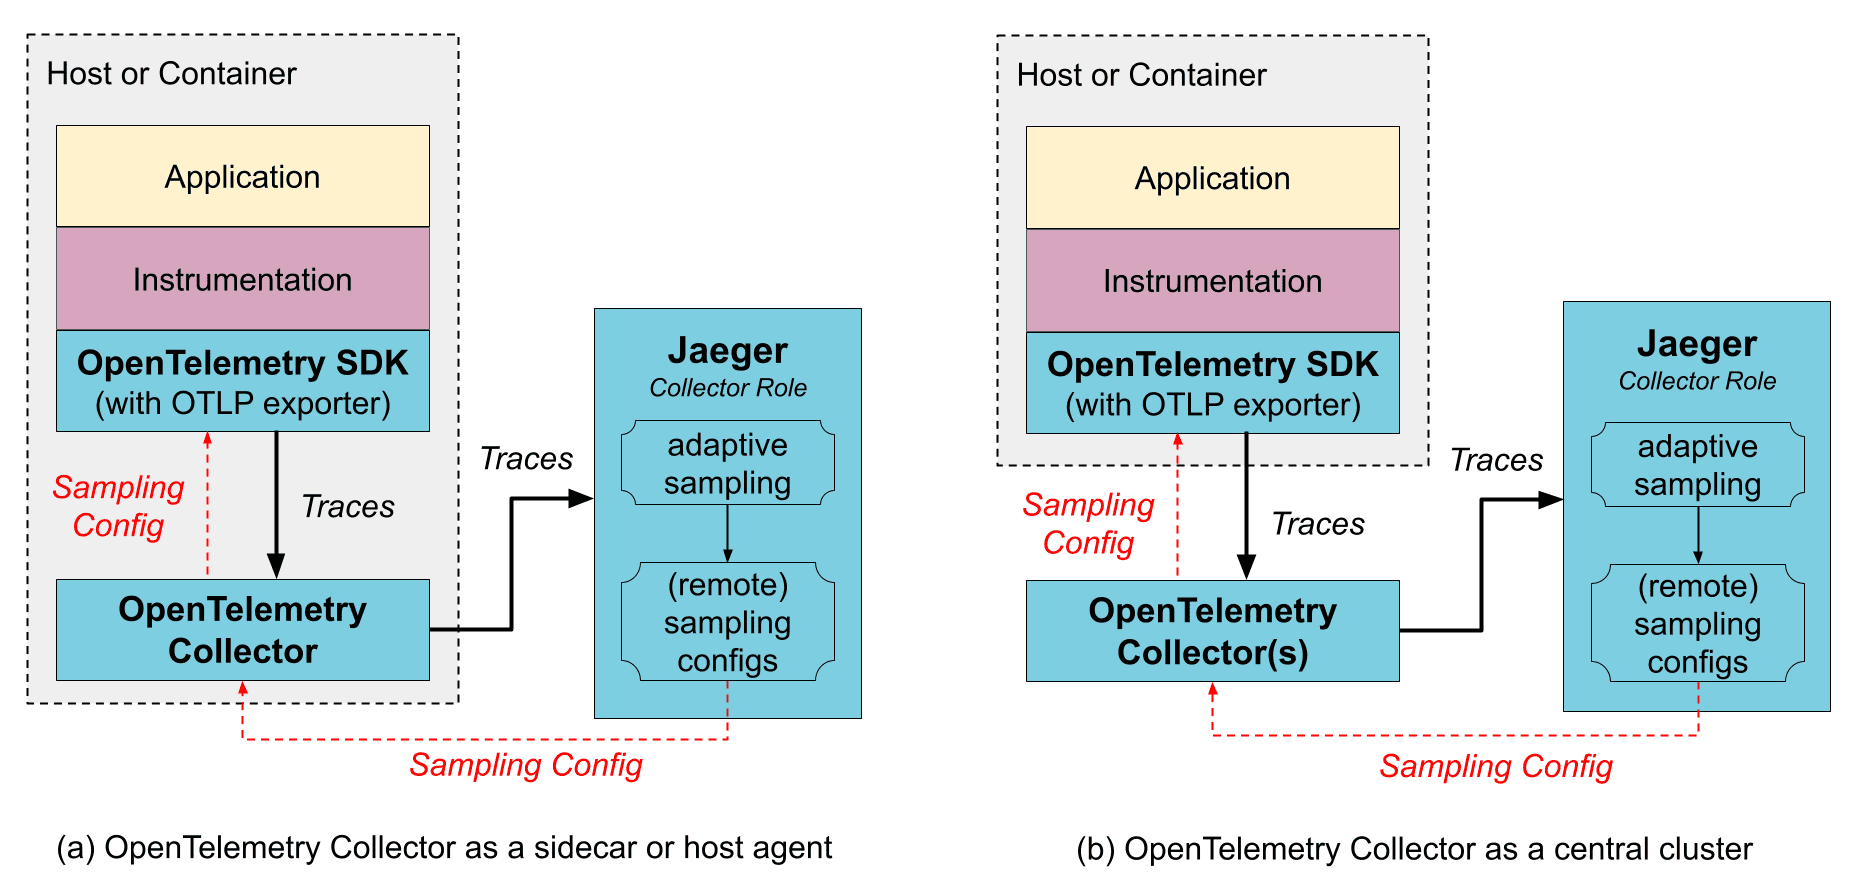
作为 sidecar / host agent 的 OpenTelemetry Collector
优点:
- SDK 配置更简单,因为 trace 导出端点和采样配置端点都可以指向本地 host,而无需关心这些服务在远程运行的位置。
- Collector 可以通过添加环境信息(例如 k8s pod 名称)来增强数据。
- 数据增强所需的资源消耗可以分布到所有 application host 上。
缺点:
- 需要额外一层数据 marshaling/unmarshaling。
作为远程集群的 OpenTelemetry Collector
优点:
- 具备分片能力,例如在使用 tail-based sampling 时。
缺点:
- 需要额外一层数据 marshaling/unmarshaling。
Jaeger Binary
Jaeger binary 构建于 OpenTelemetry Collector framework 之上,并包含:
- 官方上游组件,例如 OTLP Receiver、Batch 和 Attribute Processor 等。
- 来自
opentelemetry-collector-contrib的上游组件,例如 Kafka Exporter 和 Receiver、Tail Sampling Processor 等。 - Jaeger 自有组件,例如 Jaeger Storage Exporter、Jaeger Query Extension 等。
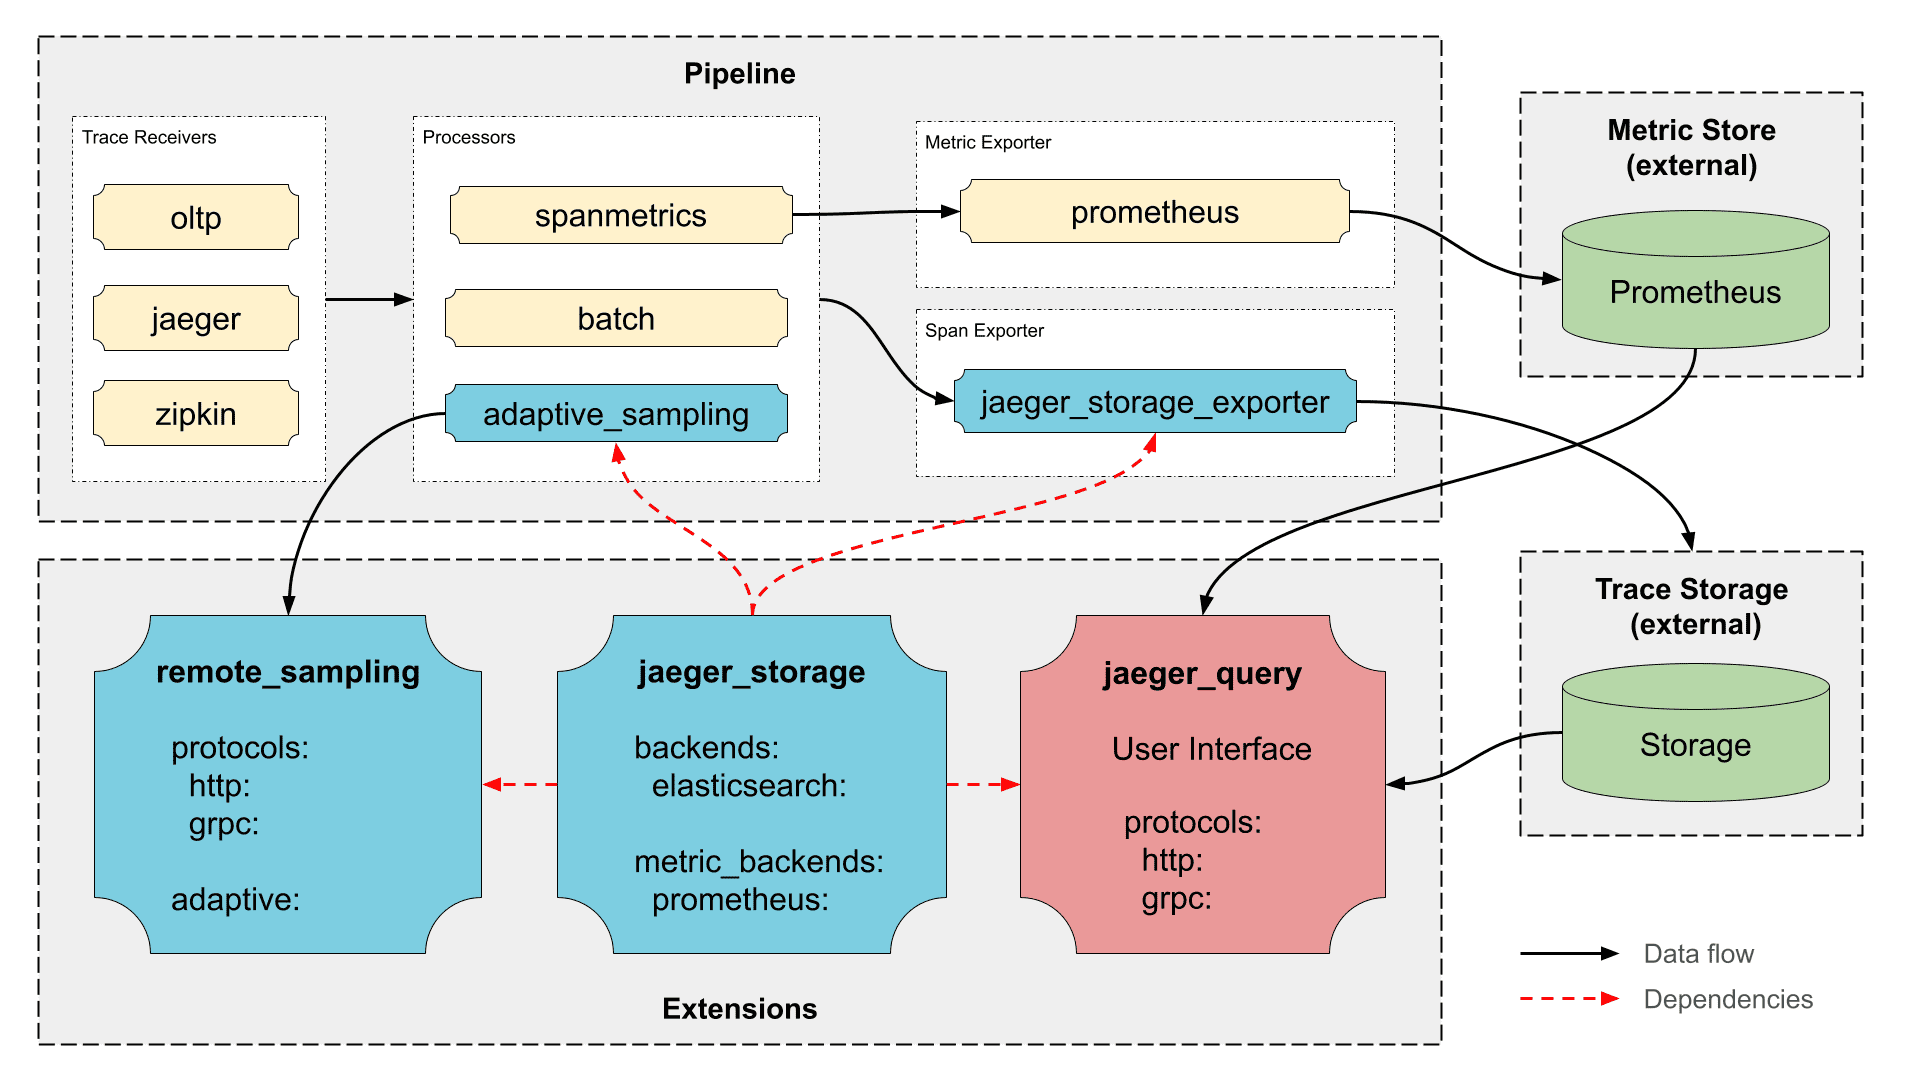
Jaeger Components
- Jaeger Storage Extension - Jaeger 中支持的存储后端的可扩展 hub。它为其他所有 Jaeger 组件提供访问 Jaeger 存储实现的能力。
- Jaeger Storage Exporter - 将 spans 写入 Jaeger Storage Extension 中配置的存储后端。
- Jaeger Query Extension - 运行 query API 和 Jaeger UI。
- Adaptive Sampling Processor - 执行 adaptive sampling 的概率计算。
- Remote Sampling Extension - 基于静态配置文件或 adaptive sampling 提供 Remote Sampling 端点。
OpenTelemetry Components
Receivers
- OTLP - 接收通过 OpenTelemetry Protocol (OTLP) 发送的 spans。
- Jaeger - 接收通过 gRPC 或 Thrift 协议传输的 Jaeger 格式 traces。
- Kafka - 接收来自 Kafka 的多种格式 spans(OTLP、Jaeger、Zipkin)。
- Zipkin - 接收使用 Zipkin v1 和 v2 协议的 spans。
- No-op - 用于不需要 ingestion pipeline 的 Jaeger UI / query service 部署。
Processors
- Batch Processor - 对 spans 进行批处理以提高效率。
- Tail Sampling - 支持高级的采集后采样。
- Memory Limiter - 当 collector 过载时支持 back-pressure。
- Attributes Processor - 允许使用 attributes 对 spans 进行过滤、重写和增强。可用于脱敏敏感数据、减少数据量或附加环境信息。
- Filter Processor - 允许从 collector 中丢弃 spans 和 span events(⚠️ 可能导致 trace 断裂)。
Exporters
- OTLP - 通过 gRPC 以 OTLP 格式发送数据。
- OTLP HTTP - 通过 HTTP 以 OTLP 格式发送数据。
- Kafka - 以多种格式(OTLP、Jaeger、Zipkin)将数据发送到 Kafka。
- Prometheus - 将 metrics 发送到 Prometheus。
- Debug - 用于 pipeline 的调试工具。
- No-op - 用于不需要 ingestion pipeline 的 Jaeger UI / query service 部署。
Connectors
- Span Metrics - 根据 span 数据生成 metrics。
- Forward - 在 collector 中转发不同 pipeline 之间的 telemetry(例如:span 到 metric / span 到 log)
Extensions
- Health Check v2 - 支持健康检查。
- zPages - 暴露 collector 的内部状态以便调试。
- Performance Profiler (pprof) - 启用 Go 的
net/http/pprof端点,通常供开发人员收集性能分析信息并排查 collector 问题。