
Active-Active 架构
Active-Active 复制组的组成方式:成员如何发现彼此、成员之间传输哪些内容、如何协调并发写入,以及为什么时钟同步是前提条件而不是建议。有关复制引擎本身——Oplog、完整同步和增量同步、端口以及 Service ID——请参阅简介。
Active-Active 模式为 alpha,仅适用于 Redis 7.2。Redis 6.0 不支持该模式——准入检查会拒绝该模式。
目录
部署架构每个成员都是写入方发现的成员关系,而非声明的链接哪些流量通过哪个端口成员生命周期重启和本地故障转移无需人工干预Redis Cluster 成员如何协调并发写入为什么同步时钟是前提条件丢失数据中心部署架构
Sentinel 模式下,一个 Active-Active 组包含三个数据中心。三个数据中心都接受本地读取和写入,并且每个数据中心的更改都会沿着独立路径到达另外两个对等成员:成员的 Primary 为该成员自己的复制代理提供数据,该代理为另外两个数据中心中的 Primaries 提供服务。因此,成员的代理只承载其自身向外发送的 Oplog——代理之间不会相互连接。每一对成员(A–B、A–C 和 B–C)在每个方向上都有独立的 Oplog 流,共计六个流。
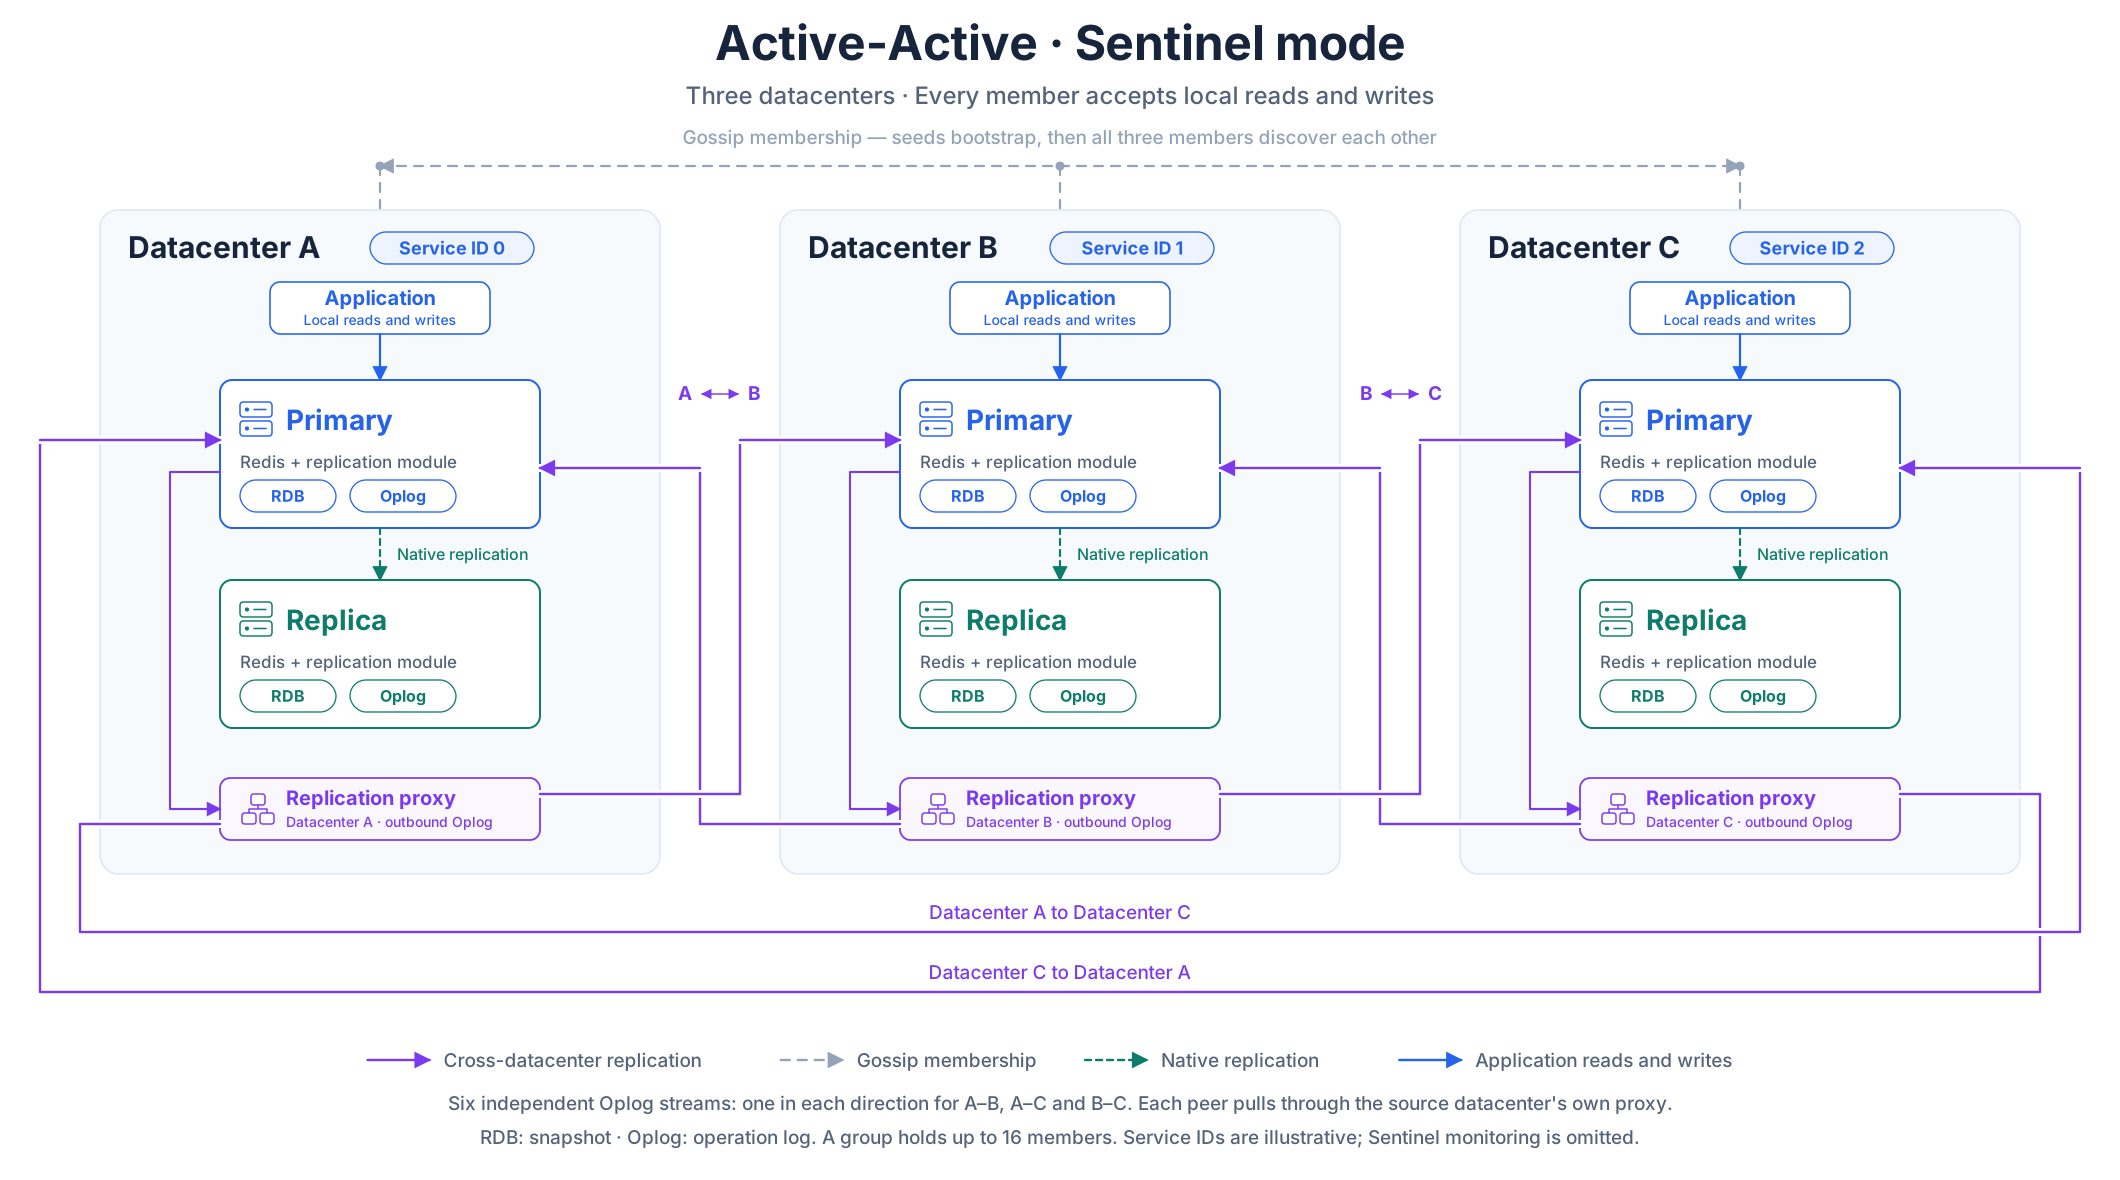
成员数量和 Service ID 仅用于示例:一个组最多包含 16 个成员,并且每一对成员的连接方式都相同。发现的成员关系,而非声明的链接介绍了成员如何发现彼此;Redis Cluster 成员包含分片架构图。
每个成员都是写入方
在 Disaster Recovery 模式下,一个实例负责写入,其余实例处于待机状态。在 Active-Active 模式下不存在待机成员:每个数据中心中的应用都会读取和写入其本地实例,并且每个成员都会将自己的更改复制到其他所有成员。
因此,每个成员同时是上游和下游——对于其自身客户端执行的更改,它是上游;对于从每个对等成员接收的更改,它是下游。底层传输机制与 Disaster Recovery 使用的机制相同:成员拉取对等成员的 Oplog,针对每个操作应用模块的冲突解决规则,在本地执行该操作,并将其追加到自己的 Oplog 中。
由此产生两个后果,这也是本页面其余内容存在的全部原因:
- 对同一个键的并发写入很正常,并非例外情况。系统会根据不同于独立 Redis 的规则自动协调这些写入。
- 数据中心丢失时无需执行提升步骤。幸存成员原本就已接受写入,因此恢复只需重定向客户端。
发现的成员关系,而非声明的链接
Disaster Recovery 会声明每条链接:每条边对应一个 ActiveRedisConnection,并标明两端。Active-Active 只声明一个起点。每个集群为其本地实例拥有一个 ActiveRedisMesh,其中包含一个简短的 seeds 列表——即其他数据中心成员的可从外部路由的地址。成员从此开始进行 gossip:它们交换成员记录,了解此前无人告知的成员,并自行建立其余链接。
由此产生的实际差异包括:
- 添加成员无需接触现有成员。 新成员只需将任何可访问的现有成员指定为种子成员,整个组便会通过 gossip 了解它。之后仍建议更新其他成员的种子列表,这样当原始种子不可访问时,重启中的成员仍可重新加入。
- 种子是引导列表,而不是成员列表。 每个远程数据中心只需一个可访问的种子成员,也可以包含本地成员自身的条目——这样每个数据中心都可以携带同一个种子列表。
- 成员关系是会收敛的状态,因此会被报告,而不是声明。
ActiveRedisMesh状态包含成员列表以及每个成员的状态。它还包含一个epoch,但这不是更改计数器:只有在某个成员被遗忘或永久停用时,它才会递增,因此,一个只增加过成员的组会报告0。
哪些流量通过哪个端口
成员在网格中通过其公布的 RESP 地址进行标识——announceAddress 和 announcePort,通常为 6379。该地址会写入种子条目,并携带在 gossip 交换的成员记录中,而且必须能够从其他每个数据中心进行路由。
实际流量——包括 gossip 轮次和复制的 Oplog——通过对等端口传输:这是 proxy Service 在同一监听器上发布的第二个端口号,你可以从 Service 中读取该端口号。模块会自行固定该端口号并原样公布,因此 proxy 前面的外部负载均衡器或防火墙必须使用相同的端口号发布它。只有 RESP 端口可以重新映射。
与 Disaster Recovery 模式一样,对等成员连接的是实例的 proxy,而不是单个 pod;proxy 会将每个连接解析到当时当前的主节点。
成员生命周期
Gossip 会通过三种状态跟踪每个成员:
默认计时器为每秒进行一次 gossip 轮次、静默 8 秒后进入 suspect,以及静默 15 秒后进入 dead;可以通过 spec.tuning 进行调整,但需谨慎操作——请参阅 Operations。永久离开的成员不会通过 operator 操作被驱逐:其记录会按照相同的计时器从存活成员的成员关系中自然过期,同时 ban 期间会防止过期节点在此期间重新公布已过时的成员关系。请参阅移除成员。
整个网格会报告一个阶段——Healthy、Degraded、Pending、Paused 或 Failed——用于概括这些成员状态。Degraded 表示网格正在有可疑或已失效成员的情况下运行,而不是健康成员之间的复制已停止。
重启和本地故障转移无需人工干预
operator 会将种子列表推送到实例的每个节点,包括从节点,而不仅仅是当前主节点。模块会在每个 pod 上重新读取该列表,并从中启动 gossip。
这正是重新加入能够自动完成的原因:当 pod 重启,或 Sentinel 或 Cluster 故障转移将从节点提升为主节点时,新提供服务的节点已经持有种子列表,并会自行重新加入网格。无需编辑任何 ActiveRedisMesh,也无需重新配置其他数据中心。
Redis Cluster 成员
在 Cluster 模式下,网格不是一个环,而是每个分片一个环:分片 0 与其他数据中心中的分片 0 进行复制,分片 1 与分片 1 进行复制,依此类推。模块会在分片位置内进行复制,不会路由哈希槽——这由 Redis Cluster 本身负责——因此,组中的每个成员都必须具有匹配的分片数量和槽布局。出于这一原因,ActiveRedisMesh 状态会报告 shardID,以及每个成员对应的 serviceID。
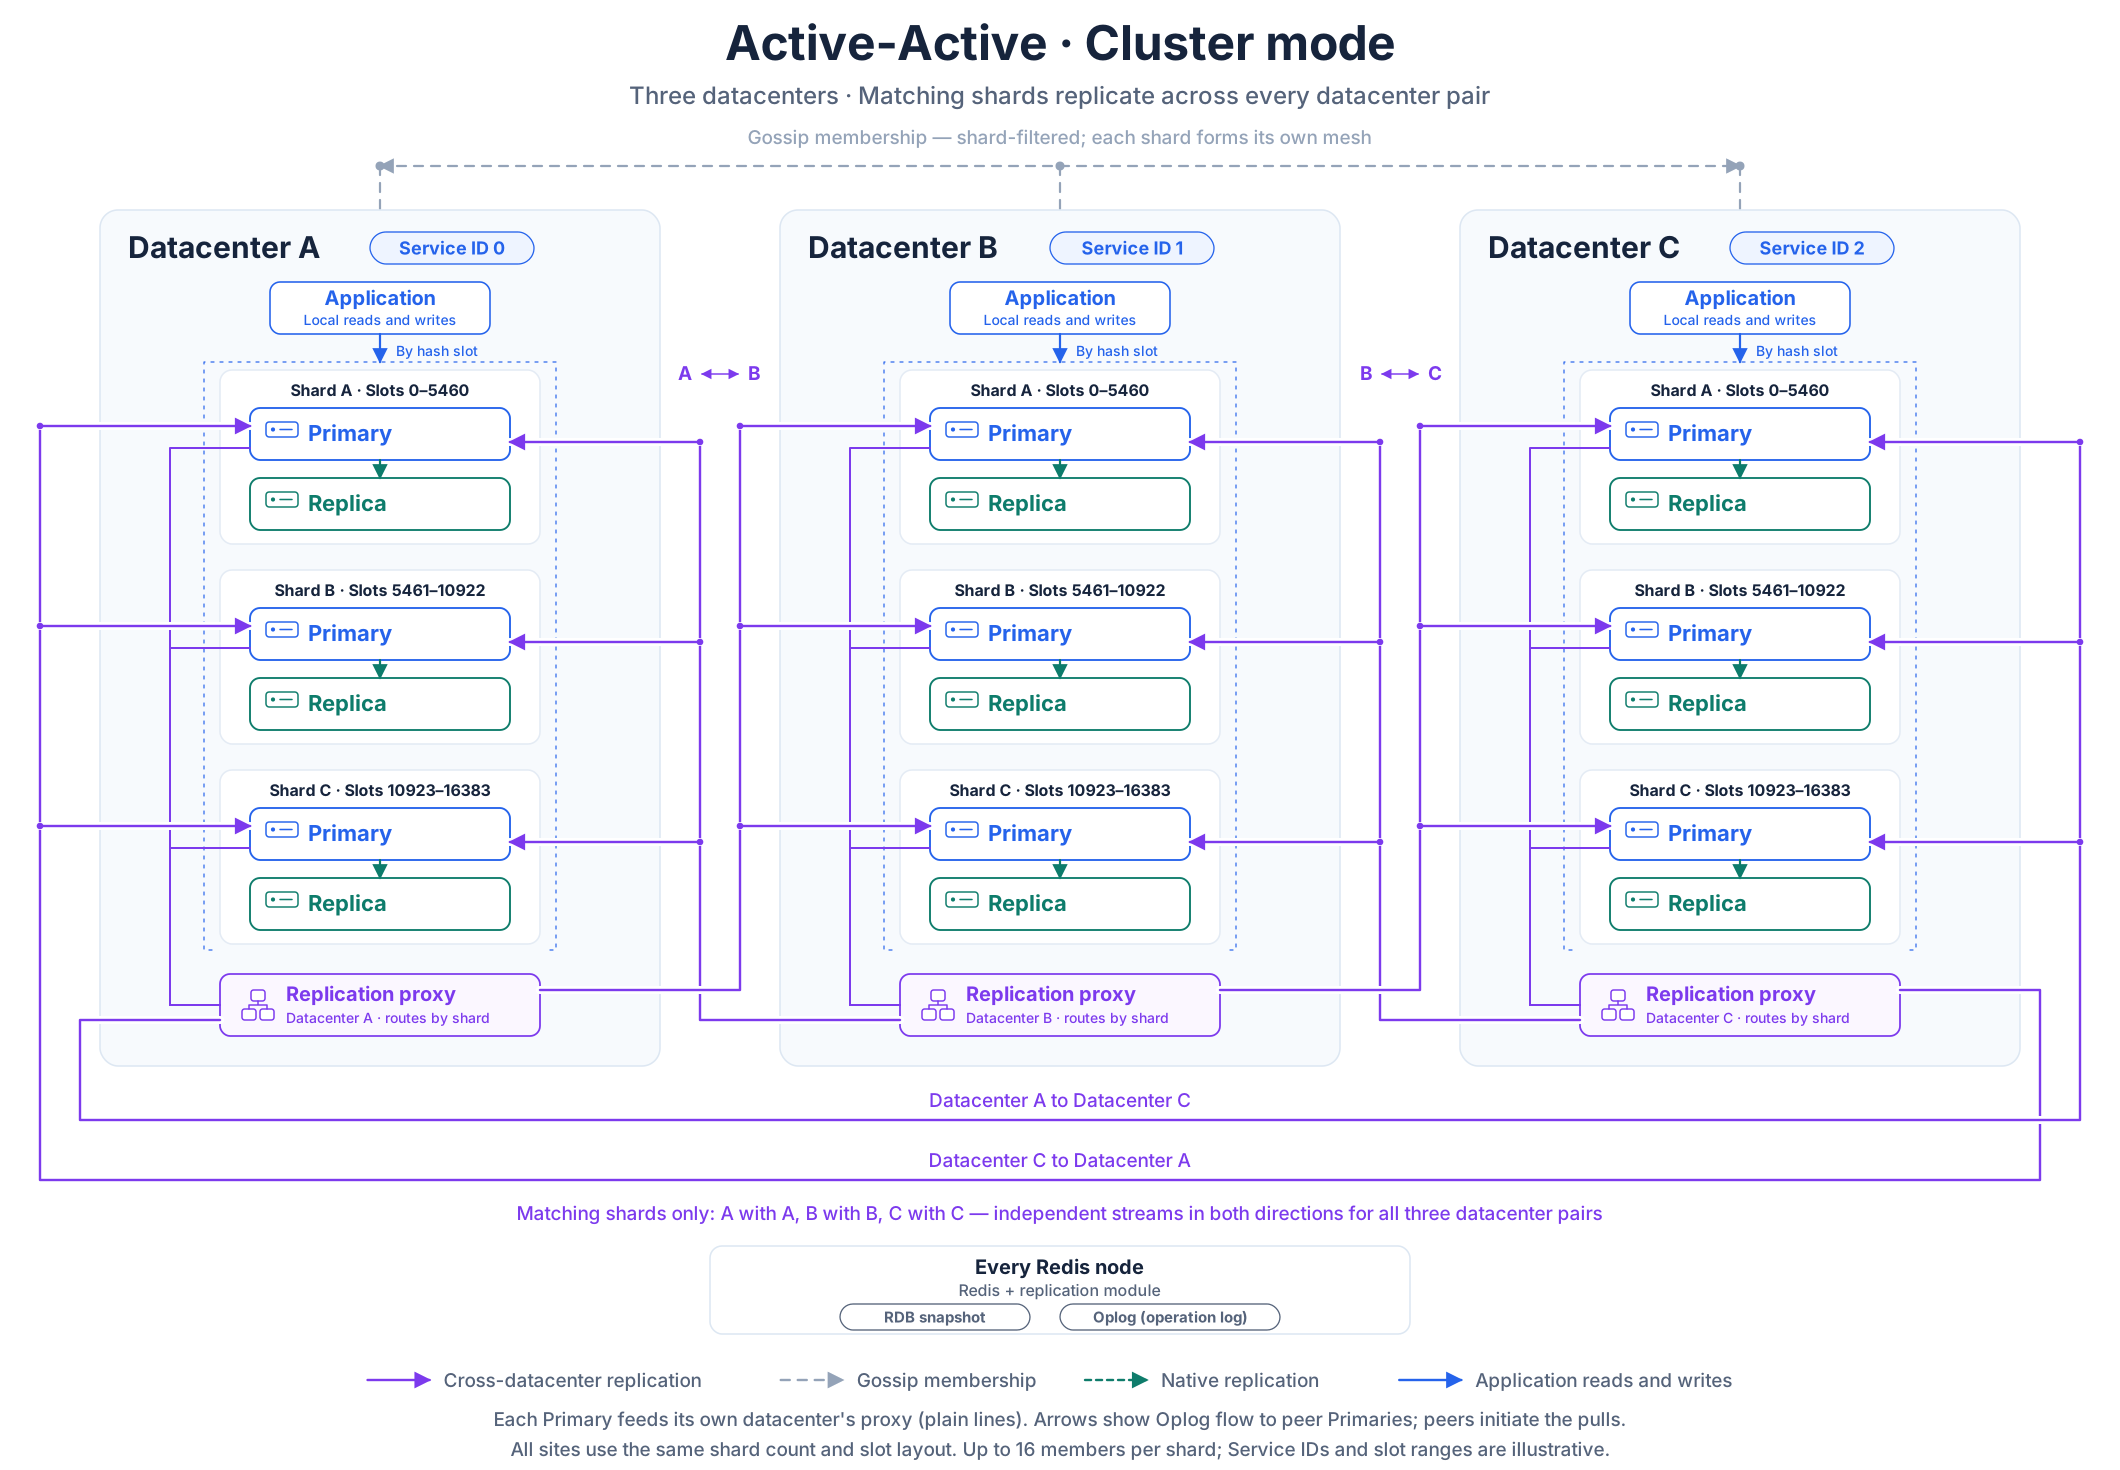
槽范围和三分片布局仅用于说明;重要的是每个成员都使用相同的分片数量和槽布局。由于 gossip 会按分片进行筛选,成员的分片 0 只会与其他位置的分片 0 建立联系——这些环不会交叉。
如何协调并发写入
当两个数据中心在同一时刻写入同一个键时,两次写入都会被复制并到达。模块会针对每个键,以及结构化类型中的每个字段,分别决定最终结果,而不是简单地让最后到达的消息获胜:
- 大多数值采用最后写入获胜策略,依据 Hybrid Logical Clock 进行比较,其物理组件是写入成员的墙上时钟毫秒值。
- 计数器采用累加策略,因此不同成员上的并发递增都会计入结果。
- 集合采用添加获胜策略,因此对同一元素进行并发添加和移除时,该元素仍会保留。
- 删除会作为墓碑保留,直到每个活跃成员都确认已收到删除操作,从而避免尚未看到该删除操作的对等成员将其撤销。
这些规则是 Redis 7.2 模块的属性,因此在灾难恢复模式下同样生效。Active-Active 改变的是暴露方式:当写入同时从多个数据中心到达时,这些规则会持续发挥作用,而不只是偶尔在向下游写入时才被触发。
命令支持是逐条命令的参考,其中说明哪些命令会被拒绝、哪些命令仅在本地执行且永不复制,以及每次复制写入采用哪种策略。在让应用连接到 Active-Active 组之前,请先阅读该参考。
为什么同步时钟是前提条件
由于最后写入胜出依据墙上时钟时间决定,因此协调结果的正确性取决于各成员对当前时间达成一致。模块会测量成员之间的时钟偏差并触发告警,但绝不会因此阻止写入,也不会丢弃对等成员 — 保持时钟同步是 operator 的责任。
时钟偏差会产生以下两种影响,其程度都与时钟相差的幅度成正比,并且发生时都不会产生错误:
- 快速时钟会赢得本应输掉的冲突。某个成员在真实时间上较晚写入的值,可能会被时钟走快的成员较早发起的写入静默覆盖。
- 已删除的数据可能重新出现。墓碑会根据墙上时钟的存留时长下限释放。当时钟偏差接近该下限的一半时,某个成员可能释放墓碑,而来自时钟偏差成员的并发添加仍在传输中,导致已删除的元素重新出现。这是真正的收敛中断,而不是暂时性不一致。
在组中每个集群的每个节点上运行时间同步守护进程,最好使用一个公共时间源,并监控时钟偏差指标的告警。运维介绍了相关阈值、如何读取测量值,以及如何确认某个具体问题是由时钟偏差导致的。
此要求仅适用于 Active-Active。在 Disaster Recovery 模式下,只有上游会接受应用写入,因此不存在需要由时钟偏差来仲裁的并发冲突写入。
丢失数据中心
Active-Active 模式没有故障转移操作步骤,因为没有需要提升的成员。剩余成员会始终继续接受写入,而恢复分为两部分:
- 将受影响的客户端重定向到某个剩余成员。平台不会提供客户端切换器;有关切换策略及其权衡(同样适用于此处),请参阅客户端 Disaster Recovery 切换。
- 从组中移除丢失的成员(如果该成员不会恢复)— 请参阅移除成员。
丢失的数据中心已接受但尚未复制的写入会随其一同丢失,这与 Disaster Recovery 模式下发生故障的上游尚未复制的写入完全相同。